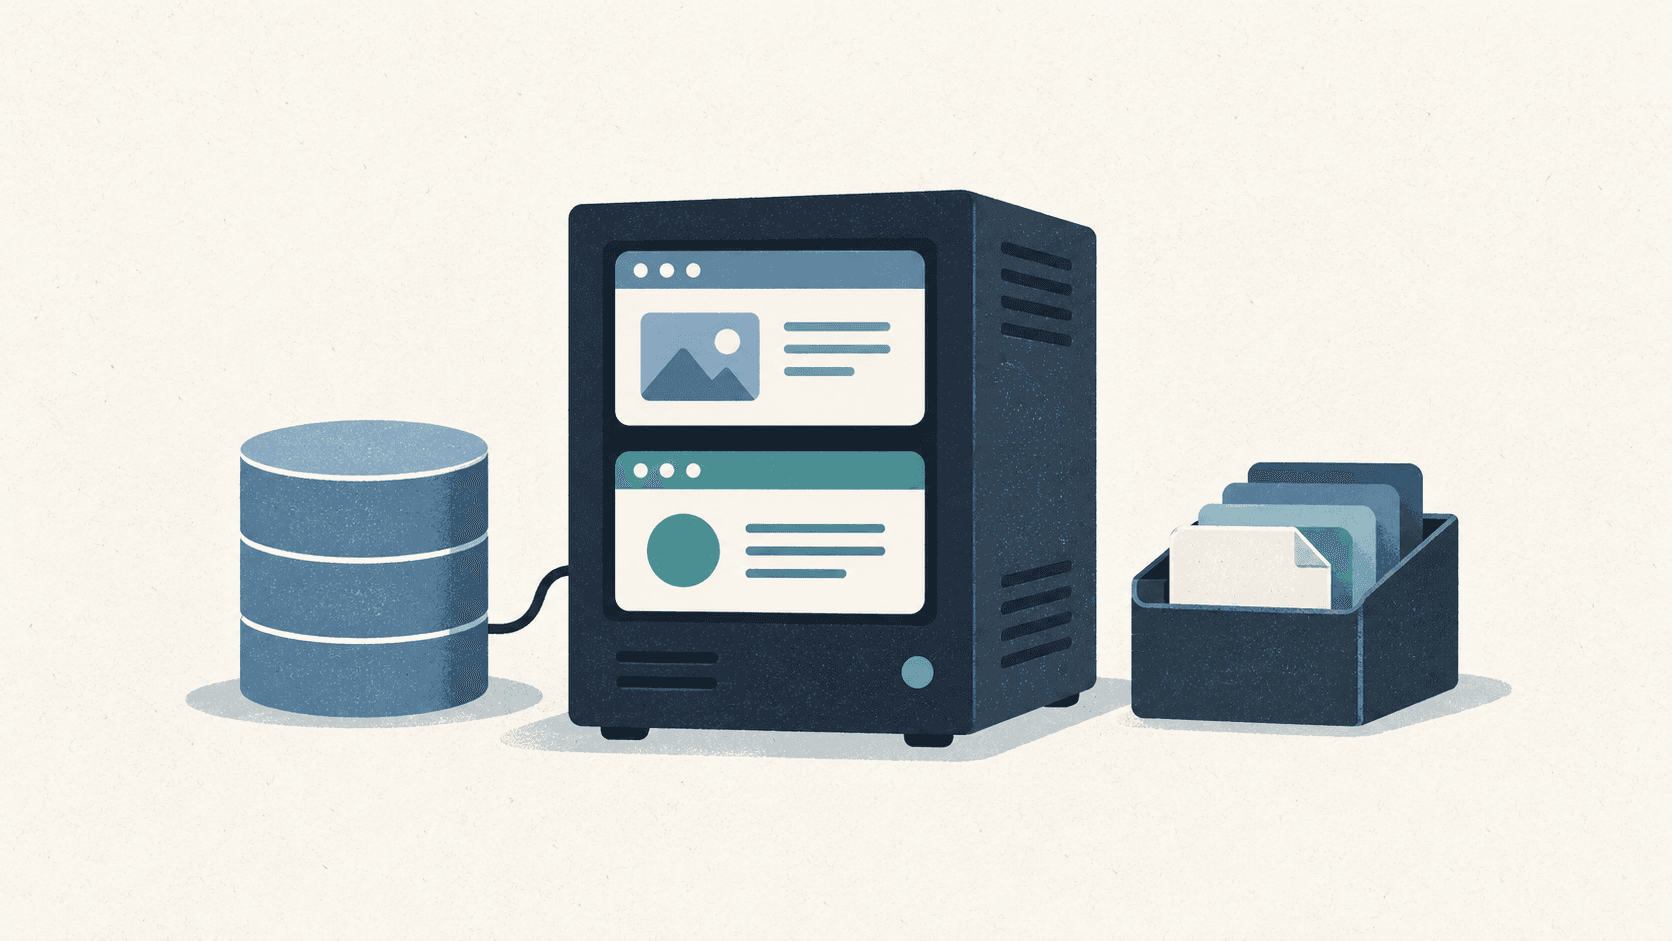
두 서비스와 데이터, 백업 저장소를 그린 삽화예요.
Game Mate와 사진 커뮤니티의 배포를 준비하면서 가장 먼저 줄이고 싶었던 건 고정 비용이었어요. 앱은 EC2 한 대에, PostgreSQL은 RDS에 두는 구성이었는데 DB까지 같은 서버에 넣으면 어떨까 생각했어요.
배포가 익숙하지 않아서 EC2로 바로 결정하지는 못했어요. Cloudflare에서 기존 컨테이너를 쓸 수 있는지, 서버리스로 갔다가 다시 돌아오는 데 무엇이 필요한지부터 알아봤어요. 상품 이름을 비교하다 보니 결국 옮겨야 할 코드와 직접 챙길 작업을 함께 보게 됐어요.
서버리스로 옮길까도 생각했어요
Cloudflare에서 EC2 같은 역할을 하는 게 뭔지부터 궁금했어요. Workers와 Containers를 알아보고, R2에 지금 쓰는 presigned 업로드를 붙일 수 있는지도 확인했어요.
같은 서버리스라도 기존 Docker 이미지를 실행하는 곳과 Workers는 달랐어요. 전자는 배포 설정부터 바꾸면 되지만, 후자는 API의 실행 방식까지 봐야 했어요. Game Mate의 채팅 SSE 연결과 사진 서비스의 프로세스 안에서 도는 주기 작업을 어디서 유지할지가 걸렸어요.
Hyperdrive도 처음에는 DB를 대신해 주는 건가 싶었어요. 설명을 보니 이미 있는 DB의 연결과 쿼리를 가속하는 서비스였어요. 결국 PostgreSQL을 둘 곳은 따로 필요했어요.
나중에 EC2로 돌아온다고 해도 같은 컨테이너와 PostgreSQL을 유지했느냐에 따라 일이 달라져요. 특정 플랫폼에 맞춰 API를 고치면 그 부분도 되돌려야 했어요.
제가 이미 만들어 둔 건 Node 서버와 Docker 배포 구성이었어요. Terraform과 S3, IAM도 AWS에 맞춰 준비하고 있었고요. 이 구성을 먼저 완성해 EC2 small에서 시작하는 쪽으로 정했어요.
사용량 과금도 결정에 걸렸어요. 작은 서비스라도 누군가 반복 호출하면 비용은 늘 수 있어요. Workers 문서의 실행당 CPU 제한은 한 번의 실행을 제한하지만 전체 호출 수를 줄이지는 않아요. 서버리스 비용을 비교하려면 요청을 받는 양을 어디서 제한할지도 포함해야 했어요.
small 한 대에 DB까지 넣으면 괜찮을까
PostgreSQL을 EC2의 컨테이너로 옮기는 대신 감수할 것도 분명했어요. 그 서버가 멈추면 웹과 API, DB가 함께 멈춰요. RDS를 쓰지 않는 만큼 백업과 복구도 제가 준비해야 했어요.
EC2 한 대
  Caddy :443
    ├─ Game Mate Web ─ Game Mate API ─┐
    └─ 사진 커뮤니티 Web ─ 사진 API ──┤
                                    └─ PostgreSQL 컨테이너
                                         ├─ game_feedback DB
                                         └─ photo_contest DB
별도 EBS 볼륨       PostgreSQL 데이터
비공개 미디어 S3    서비스별 파일 경로
별도 백업 S3        배포 전 DB 덤프
블로그는 이 서버에 넣지 않고 Vercel에 따로 두기로 했어요. PostgreSQL은 하나지만 서비스별 DB와 계정은 나눴고, API 실행 계정과 migration 계정도 따로 뒀어요.
t3.small로 시작하는 설정은 메모리 2GiB와 swap 2GiB를 사용해요. 그런데 Caddy와 PostgreSQL, 두 서비스의 Web과 API 컨테이너 한도를 합하면 약 3.1GiB예요. 한도를 모두 쓰는 순간에는 물리 메모리보다 필요한 양이 많아져요.
컨테이너 한도가 그만큼의 메모리를 미리 예약하는 건 아니어서 이 합만으로 실행할 수 없다고 볼 수는 없어요. 다만 swap을 계속 쓰거나 OOM으로 컨테이너가 죽으면 4GiB로 올리기로 했어요. small을 유지할 수 있는지는 부하를 넣었을 때의 메모리와 응답을 봐야 해요.
비용을 비교할 때는 인스턴스 요금에 EBS와 공인 IPv4, 스냅샷, S3 저장과 요청, 전송 요금을 더해서 봤어요. RDS를 뺀다고 이 비용들까지 없어지는 건 아니었어요.
DB를 직접 돌리기로 했으니 백업도 필요했어요
DB 데이터는 루트 디스크와 분리한 암호화 EBS 볼륨에 두기로 했어요. /srv/side-postgres에 마운트하고, 그 안에 볼륨을 확인할 표시 파일을 둬요. 표시 파일이 없으면 DB 시작을 멈추게 했어요. 마운트가 빠진 상태에서 루트 디스크에 빈 DB가 생기는 일을 막기 위해서예요.
볼륨 스냅샷은 매일 만들고 기본 7개를 남기도록 했어요. 배포할 때는 migration 직전에 해당 서비스 DB를 pg_dump로 떠서 별도의 S3 백업 버킷에 올려요. 덤프를 만들거나 올리는 데 실패하면 migration도 멈춰요. 배포와 백업 스크립트에 이 순서를 넣었어요.
복구는 앱 이미지를 되돌리는 것과 나눴어요. 이전 버전의 컨테이너를 띄워도 이미 적용한 migration은 남아요. 그래서 이전 앱이 바뀐 스키마에서 동작하는지 확인하는 절차와, DB를 백업으로 복원하는 절차를 따로 두었어요.
이 백업은 RDS처럼 특정 시점으로 되돌리는 방식은 아니에요. 스냅샷으로 볼륨을 복원하거나 덤프를 새 DB에 넣는 방식이에요. 실제 AWS에서 그 복원을 해 보는 단계는 아직 남아 있어요.
S3 권한을 넣었는데도 CI가 실패했어요
미디어는 기존 S3 버킷 하나에서 프로젝트별로 폴더를 나눠 쓰고 싶었어요. 처음 코드는 버킷이 서비스마다 따로 있다고 가정하고 있어서, 이 부분부터 바꿨어요.
media-bucket/
  game-feedback/
    production/...
    ci/...
  photo-contest/
    production/...
    ci/...
backup-bucket/
  postgres/...
운영 키는 자기 서비스의 production/ 아래만 읽고 쓰게 했어요. 테스트는 ci/ 아래에 실행별 경로를 만들어 사용해요. 콘솔에서는 폴더처럼 보이지만 실제로는 객체 이름의 접두사라서, 이름을 나눴다고 권한까지 나뉘는 건 아니었어요.
처음 IAM 정책에 GetObject, PutObject, DeleteObject를 넣었는데도 CI 업로드가 실패했어요. 업로드 전에 목록을 조회하고 있었기 때문이에요. 파일 하나를 다루는 권한과 버킷에서 이름을 찾는 권한은 Resource부터 달랐어요.
| 작업 | Resource | 경로 제한 |
|---|---|---|
GetObject, PutObject, DeleteObject | arn:aws:s3:::media-bucket/game-feedback/production/* | 객체 ARN에 경로를 적어요 |
ListBucket | arn:aws:s3:::media-bucket | s3:prefix 조건을 붙여요 |
.../game-feedback/만 적으면 그 안의 파일 전체를 가리키는 게 아니었어요. 파일에는 *까지 붙여야 했고, 목록 조회는 버킷 ARN에 권한을 준 뒤 접두사로 제한해야 했어요. 수정한 IAM 정책에는 두 항목이 따로 있어요.
IAM을 고친 뒤에는 브라우저 업로드에서 CORS도 봐야 했어요. 테스트 origin이 허용되지 않아 막힌 경우였어요. CORS는 브라우저가 다른 출처로 접근할 수 있는지 정하고, 실제 객체를 사용할 권한은 IAM과 서명이 정해요. 둘 중 하나만 맞춰서는 업로드가 되지 않았어요.
백업 버킷은 미디어와 분리했어요. EC2 역할에는 postgres/ 아래에 덤프를 올리는 권한만 주고, 기존 덤프를 읽거나 삭제하는 권한은 주지 않았어요.
R2도 알아봤어요
R2도 S3 호환이라고 해서 현재 업로드를 그대로 쓸 수 있는지 물어봤어요. 두 서비스는 presigned POST 정책에 크기 제한을 넣어서 파일을 올리고 있었어요.
R2 공식 문서에는 GET, HEAD, PUT, DELETE는 지원하지만 HTML 폼 방식의 POST는 지원하지 않는다고 나와 있어요.
S3 호환이라는 말만으로 지금 업로드를 그대로 옮길 수는 없었어요. PUT으로 바꾸려면 POST 정책에 넣었던 조건과 업로드 완료 검사를 다시 다뤄야 해요. 우선 S3를 유지하고, 미디어 전송 비용 때문에 저장소를 바꿀 필요가 생기면 그때 이 작업을 함께 비교하기로 했어요. EC2 이전과 묶어서 결정할 일은 아니었어요.
API 도메인을 추가하면서 쿠키까지 바꾸지는 않았어요
웹과 별도로 API 도메인도 두기로 했어요. 각 서비스에 웹 호스트와 api. 호스트를 두고 Caddy가 해당 컨테이너로 요청을 넘겨요.
브라우저에서는 기존처럼 같은 출처의 /api나 /backend를 사용해요. 세션 쿠키도 웹 호스트의 host-only 쿠키를 유지했어요. 사진 서비스의 GraphQL 변경 요청은 웹 프록시를 거쳐서 Next 캐시를 갱신하는 처리도 그대로 타게 했어요.
웹 요청을 받는 포트는 Caddy의 80/443으로 모았어요. Web과 API는 서비스별 Docker 네트워크에 두고, DB 네트워크에는 API와 운영, migration 컨테이너만 연결했어요. Caddy나 Web이 DB에 직접 붙을 일은 없었어요. 프록시와 네트워크 설정에 같이 들어 있어요.
Terraform으로 인프라도 코드로 관리했어요
서버를 다시 준비할 때 콘솔에서 바꾼 설정을 기억해 내고 싶지는 않았어요. EC2와 네트워크, PostgreSQL 데이터용 EBS, IAM 정책과 백업 버킷을 Terraform에 적어 구성과 변경 내역이 저장소에 남게 했어요.
Lightsail도 검토했지만 배포 대상은 EC2로 정했어요. 쓰지 않을 Lightsail 구성과 스크립트는 지워서 배포할 경로가 섞이지 않게 했어요.
Terraform은 서버와 네트워크 같은 기반 환경을 관리하고, GitHub Actions는 이미지를 빌드해 기존 EC2에 SSH로 배포 작업을 전달하도록 나눴어요. 앱을 배포할 때는 그 서버 안의 컨테이너를 새 버전으로 교체해요.
기존 미디어 버킷은 Terraform 관리 대상에서 제외하고, DB 덤프를 받을 백업 버킷은 따로 관리해요. 처음 서버를 준비할 때 할 일은 Terraform 안내서에 적어 뒀어요.
실제 서버에서 봐야 할 것들
CloudWatch 설정에는 인스턴스 상태 검사 실패 시 재부팅과 CPU 크레딧 부족 알람을 넣었어요. 서버가 멈추면 앱에서 오류를 보낼 수도 없어서 서버 쪽 확인도 필요했어요. 알림 메일은 주소를 넣은 뒤 구독 확인까지 해야 해요.
이 구성은 실제 계정에 적용하기 전이에요. 첫 부팅에 데이터 볼륨이 붙지 않았을 때 DB가 멈추는지, 백업으로 복원할 수 있는지부터 실제 서버에서 확인해야 해요. 부하를 넣었을 때의 swap과 컨테이너 종료, 응답 시간도 small을 계속 쓸지 판단하는 기준이에요.
서비스 기획과 화면을 고친 이야기는 AI 에이전트에게 자율적으로 맡겨 보고, 결과물을 검토하며 고친 과정에 따로 적었어요.