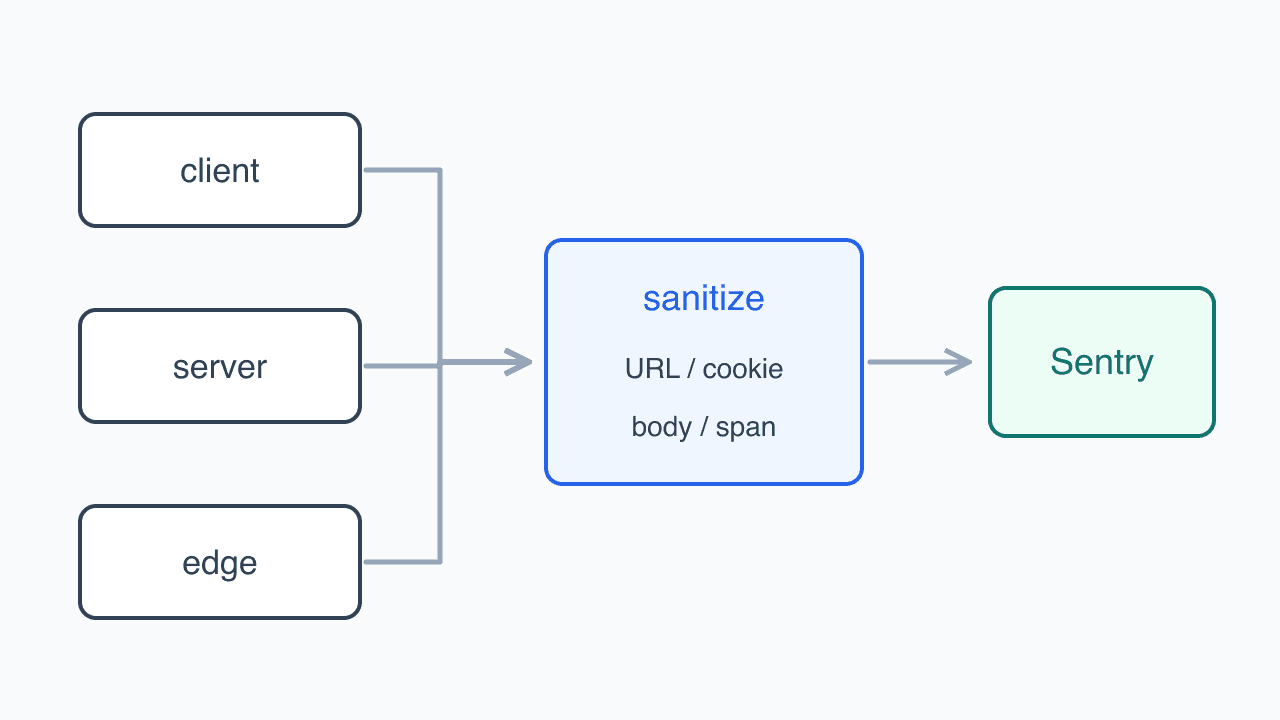
client, server, edge의 이벤트를 전송하기 전에 민감 정보를 정화해요.
복지몰에서 화면 오류와 Web Vitals를 보려고 Sentry를 붙였어요. @sentry/nextjs를 설치하고 첫 이벤트를 보내는 데는 오래 걸리지 않았어요. 막상 payload를 열어 보니 그다음부터가 문제였어요. 인증 정보가 실릴 경로가 있었고, 브라우저에서 보낸 지표가 서버에는 없었고, 빌드는 성공했는데 소스맵은 올라가지 않았어요.
각 문제를 SDK 소스와 실제 이벤트를 오가며 따라갔어요. 어떤 값을 보내지 않을지부터 정하고, 런타임마다 민감 정보가 남던 경로를 막았어요. 그 뒤에야 오류를 사용자 영향에 따라 나누고, 실제 이슈를 조사하는 데 쓸 수 있었어요. 사용한 버전은 Next.js 16과 @sentry/nextjs 10.70이에요.
세 런타임의 오류를 한곳으로 모았어요
브라우저에서 초기화한 SDK가 서버 오류까지 받지는 않아요. Next.js의 브라우저, Node, Edge가 서로 다른 SDK 구현을 쓰므로 초기화도 각각 연결했어요.
// sentry.client.ts
Sentry.init({
  dsn: SENTRY_DSN,
  enabled: IS_SENTRY_ENABLED,
  environment: SENTRY_ENVIRONMENT,
  integrations: [
    Sentry.browserTracingIntegration({
      idleTimeout: SENTRY_IDLE_TIMEOUT,
    }),
  ],
  tracesSampleRate: SENTRY_TRACES_SAMPLE_RATE,
});

// sentry.server.ts
Sentry.init({
  dsn: SENTRY_DSN,
  enabled: IS_SENTRY_ENABLED,
  environment: SENTRY_ENVIRONMENT,
  integrations: [
    Sentry.httpIntegration({
      disableIncomingRequestSpans: true,
      maxIncomingRequestBodySize: 'none',
    }),
  ],
});
브라우저는 instrumentation-client.ts에서 초기화하고, Node와 Edge는 instrumentation.ts의 register()에서 현재 런타임에 맞는 초기화 함수를 불러요. 라우터 이동이 시작된 시점부터 navigation transaction을 잡도록 captureRouterTransitionStart도 연결했어요.
서버 컴포넌트 렌더링, 라우트 핸들러, 서버 액션, proxy에서 난 오류는 Next.js의 onRequestError로 넘겼는데요. API 인터셉터에서 이미 수집한 오류라면 다시 보내지 않아요.
이렇게 모으니 같은 오류가 여러 수집 지점을 지날 수 있었어요. API 인터셉터에서 보낸 객체가 에러 바운더리와 onRequestError까지 올라가면 이슈가 나뉘어요. captureError가 처리한 객체에는 열거되지 않는 심볼을 남기고, 위쪽에서는 그 표식을 보고 건너뛰게 했어요.
보내지 않기로 거른 오류에도 표식은 필요했어요. 그렇지 않으면 인터셉터가 제외한 오류를 에러 바운더리가 다시 fatal로 보내게 돼요.
요청 정보의 자동 수집 범위를 확인했어요
먼저 sendDefaultPii: false가 어떤 값을 막는지 따라갔어요. 10.70에서는 이 옵션만으로 event.request의 헤더와 쿠키가 모두 빠지지 않았어요. 인증 토큰 쿠키도 포함될 수 있었어요. 여기서는 쿠키 이름을 sessionToken과 renewalToken으로 바꿔 적었어요.
이 옵션은 헤더, 쿠키 수집을 false로 끄는 게 아니라, 제외할 이름을 담은 deny 목록 객체로 바꿔요. 그런데 이벤트에 요청 정보를 싣는 requestDataIntegration은 값이 false인지만 확인해서, 객체가 오면 켜진 것으로 보고 목록을 적용하지 않은 채 헤더와 쿠키를 그대로 실었어요. deny 목록으로 거르는 코드는 span 경로에만 있었고요.
의료 정보를 다루는 이 서비스에서는 요청 맥락이 유용해도 인증 정보나 사용자 입력을 함께 보낼 수는 없었어요. dataCollection에 요청 헤더, 쿠키, 본문, 쿼리와 사용자 입력을 수집하지 않도록 하나씩 적었어요.
export const SENTRY_DATA_COLLECTION = {
  userInfo: false,
  cookies: false,
  httpHeaders: { request: false, response: false },
  httpBodies: [],
  urlQueryParams: false,
  genAI: { inputs: false, outputs: false },
  databaseQueryData: false,
  graphQL: { document: false, variables: false },
  stackFrameVariables: false,
  frameContextLines: 5,
};
AI 입력과 출력도 닫았어요. 상담 기능의 프롬프트와 응답에는 사용자가 쓴 내용이 들어갈 수 있으니까요. GraphQL과 데이터베이스 계측은 지금 쓰지 않지만, 나중에 통합이 추가되더라도 닫힌 채로 시작하도록 명시했고요.
stackFrameVariables도 중요했어요. Node의 localVariablesIntegration은 예외 프레임의 지역 변수를 이슈에 붙여요. 오류가 난 함수의 지역 변수에 회원 정보나 토큰이 있으면 그대로 수집될 수 있었어요.
frameContextLines는 5줄을 남겼어요. 이 값은 사용자 입력 대신 소스를 보내고, 목적지도 사내 Sentry라 디버깅에 쓰는 쪽을 골랐어요. 다만 서버 소스맵은 업로드하지 않아 Node 이벤트에는 minify된 줄이 붙어요. 소스맵을 제외한 이유는 뒤에서 다룰게요.
새 수집 키가 생기면 타입 검사가 깨지게 했어요
dataCollection에 객체를 넘겨도 빠뜨린 항목은 수집하지 않는 상태가 되지 않아요. 생략한 키는 전부 수집하는 쪽으로 열려요. 처음 설정에서 stackFrameVariables와 graphQL이 빠진 걸 보고, 다음 SDK 업데이트에서도 같은 실수를 할 수 있겠다고 생각했어요.
SDK의 타입을 그대로 붙이는 것만으로는 막을 수 없었어요. 원본 타입의 모든 필드가 optional이거든요.
type TSentryDataCollection = NonNullable<NonNullable<Parameters<typeof init>[0]>['dataCollection']>;

type TClosedDataCollection = Required<Omit<TSentryDataCollection, 'queryParams'>> & {
  httpHeaders: Required<NonNullable<TSentryDataCollection['httpHeaders']>>;
  graphQL: Required<NonNullable<TSentryDataCollection['graphQL']>>;
  genAI: Required<NonNullable<TSentryDataCollection['genAI']>>;
};
Required로 필수 필드를 만들면 SDK가 새 항목을 추가할 때 그 값을 정하기 전까지 타입 검사가 실패해요.
이미 적은 값을 실수로 true로 바꾸는 경우는 타입으로 잡을 수 없어서, 테스트에서는 전체 객체를 toEqual로 비교해요. 새 키의 누락과 기존 수집 값의 변경을 나눠 잡도록 했어요.
breadcrumb은 dataCollection이 걸러 주지 않았어요
헤더와 쿠키를 막은 뒤에도 토큰이 나가는 경로가 하나 더 있었어요. 이번에는 오류 이벤트가 아니라 breadcrumb이었는데요.
dataCollection은 SDK가 자동으로 수집하는 request data에 적용돼요. breadcrumb은 그 바깥이에요. console breadcrumb에는 인자로 넘긴 값이 그대로 들어가는데, 코드베이스에 axios 오류 객체를 console.error로 넘기는 곳이 있었어요. 그 객체의 config.headers에 인증 정보가 들어 있었고요.
console breadcrumb은 통째로 버렸어요. 같은 오류는 이벤트로 따로 수집하니 console 인자를 다시 보낼 필요가 없었어요.
fetch, xhr, history breadcrumb은 URL의 쿼리와 해시를 지웠어요. Node의 http breadcrumb은 쿼리를 http.query라는 별도 키에도 넣어서 그 값도 삭제했고요.
export function sanitizeBreadcrumb(breadcrumb: Breadcrumb): Breadcrumb | null {
  if (breadcrumb.category === 'console') return null;
  if (!breadcrumb.data) return breadcrumb;

  const data = { ...breadcrumb.data };

  ['url', 'from', 'to'].forEach((key) => {
    const value = data[key];

    if (typeof value === 'string') {
      data[key] = stripUrlParams(value);
    }
  });

  delete data['http.query'];
  delete data['url.query'];
  delete data['http.fragment'];

  return { ...breadcrumb, data };
}
애플리케이션에서 직접 context에 넣은 값도 자동 수집 옵션의 밖에 있었어요. 그래서 화면과 요청의 위치를 붙이는 코드에서도 URL을 그대로 보내지 않도록 바꿨어요.
- 화면 위치는 location.href가 아니라 pathname만 써요.
- API URL은 쿼리와 해시를 지워요.
- 숫자, UUID 경로는 :id로 접어 개인정보와 이슈 그룹 폭증을 함께 막아요.
- OAuth callback의 code, state, 검색 조건, 회원 식별자가 URL에 남지 않게 했어요.
URL과 본문은 읽는 단계와 전송 직전 두 곳에서 닫았어요
헤더와 breadcrumb을 고친 뒤에도 URL과 본문이 남는 곳을 코드 리뷰와 SDK 소스에서 더 찾았어요. 옵션 이름이 요청 전체를 막는 것처럼 보여도, 실제로는 특정 필드나 integration에만 적용되고 있었어요.
- urlQueryParams: false가 끄는 건 event.request.query_string 필드뿐이었어요. URL 본체는 SDK가 항상 싣게 돼 있어 쿼리를 단 채로 나갔어요.
- 브라우저에는 이 옵션을 적용하는 통합 자체가 없었어요. 기본 통합이 location.href 전체와 Referer를 모든 이벤트와 pageload transaction에 실었어요.
- httpBodies: []로는 요청 본문이 막히지 않았어요. Node의 httpIntegration은 이 값과 상관없이 기본값 'medium'으로 들어오는 요청 본문을 읽어 스코프에 올리고, 요청 정보를 이벤트에 싣는 쪽은 스코프에 있는 본문을 그대로 붙였어요. 본인인증 콜백 같은 POST 본문이 이슈에 남을 수 있는 구조였어요.
그래서 자동 수집 설정과 별개로 읽는 단계와 전송 직전, 두 곳에서 다시 닫았어요. Node에서는 먼저 본문을 읽지 않도록 했어요.
Sentry.httpIntegration({
  disableIncomingRequestSpans: true,
  maxIncomingRequestBodySize: 'none',
});
disableIncomingRequestSpans도 함께 넘겨야 했어요. 직접 넘긴 httpIntegration이 @sentry/nextjs가 기본으로 넣는 같은 이름의 Http 통합을 통째로 대체하는데, 그 기본 통합이 바로 이 값을 켜 둔 것이었거든요. 이 값을 빠뜨리면 Next.js와 Sentry가 같은 incoming request span을 두 번 만들어요.
읽는 단계에서 막은 뒤에도 전송 직전에 한 번 더 지웠어요.
Sentry.init({
  beforeBreadcrumb: sanitizeBreadcrumb,
  beforeSend: sanitizeEvent,
  beforeSendTransaction: sanitizeEvent,
  beforeSendSpan: sanitizeSpan,
  dataCollection: SENTRY_DATA_COLLECTION,
});
이제 Node는 본문을 읽지 않고, 전송 직전 훅은 이벤트에 남은 요청 정보와 span 속성을 지워요. dataCollection으로 막은 쿠키와 본문도 다시 삭제해요. 읽지 않도록 설정한 것과 마지막 payload에서 제거하는 것을 둘 다 둔 거예요.
이 함수가 모르는 이름으로 SDK가 URL을 넣으면 그대로 남을 수는 있어요. SDK를 올릴 때 새 URL 필드와 span 속성을 다시 따라가야 하는 이유예요.
sanitizeEvent는 다음을 처리해요.
- event.request.url의 쿼리, 해시 제거
- query_string, cookies, data 삭제
- 대소문자와 관계없이 Referer의 쿼리 제거
- trace와 child span 속성 정리
URL은 한 가지 키로만 오지 않았어요.
const URL_ATTRIBUTE_KEYS = ['url', 'url.full', 'http.url', 'http.target', 'http.request.header.referer'];

const QUERY_DATA_KEYS = ['http.query', 'url.query', 'http.fragment'];
특히 plain url이 마지막까지 남았어요. fetch, xhr 계측은 정리한 URL을 http.url이나 url.full에 넣으면서, 별도 url 속성에는 정리하지 않은 원본을 넣는데요. 이 앱의 API 호출은 axios(xhr)로 나가서, 쿼리가 붙은 호출은 전부 이 키에 원본 쿼리를 남겼어요.
처음에는 나머지 네 키만 닦고 있었어요. url을 목록에 넣기 전까지는 정화한 URL과 원본 URL이 같은 span에 나란히 실렸어요.
INP처럼 transaction에 속하지 않고 따로 전송되는 span은 beforeSendTransaction을 거치지 않아요. 그래서 같은 속성 정화를 beforeSendSpan에도 연결했어요.
정화 함수를 초기화에 연결했는지도 검사해요
정화 함수가 맞아도 Sentry.init에 넘기지 않으면 원본이 나가요. 함수 테스트와 별개로 client, server, edge 초기화에 dataCollection과 각 훅이 전달되는지도 검사했어요.
함수 테스트에는 URL, 본문, 쿠키, 대소문자가 다른 Referer, breadcrumb과 span 속성을 넣었어요. 정책 객체는 모든 키와 값을 한꺼번에 비교해요. 이 테스트는 알고 있는 필드와 연결을 지켜 주지만, SDK가 다른 이름의 속성을 새로 쓰는 경우까지 찾아주지는 않아요.
Web Vitals는 실제 Sentry envelope까지 확인했어요
브라우저에서는 browserTracingIntegration이 LCP, CLS, TTFB, FCP를 pageload transaction의 measurement로 보내요. 프로덕션 trace는 20%를 수집하고, 전송을 확인하는 배포에서는 전부 수집해요.
처음에는 기본 idleTimeout 1초를 썼는데요. 실제 수집분을 보니 LCP가 없는 pageload transaction의 지속시간 p50은 728ms였고, LCP가 실린 쪽은 2.3초였어요. transaction이 지표보다 먼저 닫히는 경우가 있다고 판단해 대기 창을 3초로 늘렸어요.
export const SENTRY_IDLE_TIMEOUT = 3_000;이 값을 늘려도 기록되는 transaction duration이 3초 늘어나지는 않아요. SDK가 idle span의 종료 시각을 마지막 child span의 끝으로 다시 자르기 때문에, Web Vitals를 기다리는 시간과 전송 시점만 달라져요.
단위 테스트로는 browserTracingIntegration, 활성화 게이트, 샘플링을 모두 지난 payload가 실제로 나가는지 알 수 없었어요. 그래서 별도의 Playwright 실행 경로를 만들었어요.
npm run test:e2e:sentry테스트에서는 Sentry의 envelope 요청을 page.route로 가로채고, 실제 서버에는 보내지 않은 채 transaction payload를 읽어요. pageload transaction에 fcp, lcp, ttfb measurement가 실렸는지 확인하는데요.
MSW 서비스 워커가 요청을 넘겨받으면 page.route가 envelope를 잡지 못해서, 이 E2E 컨텍스트에서는 서비스 워커도 막았어요. 응답을 주지 않으면 SDK가 재시도하므로 가짜 성공 응답까지 돌려줘요.
옵션이 전달됐다는 사실보다 브라우저가 실제로 만든 envelope를 보는 게 목적이에요.
브라우저 진입
  → browserTracingIntegration
  → pageload transaction 종료
  → Sentry envelope 생성
  → measurement 포함 여부 확인
envelope에는 지표가 담겨 있었어요. 그런데 사내 Sentry 대시보드에서는 일부 지표가 보이지 않았어요.
INP는 앱이 보내도 서버가 저장하지 않았어요
여기에는 중요한 한계가 있었어요. 지금 SDK에서 INP는 pageload transaction의 measurement가 아니라 standalone span으로 전송돼요.
사내 Sentry 환경에서는 span ingestion이 꺼져 있어 dataset=spans가 비어 있었어요. 그래서 INP가 저장되지 않았고, Insights의 Web Vitals 화면도 비어 보였는데요. 지금은 Discover에서 transaction dataset과 transaction.op:pageload를 기준으로 LCP, CLS, TTFB, FCP를 확인해요.
LCP와 CLS, TTFB, FCP는 이렇게 조회할 수 있지만, 어느 값부터 개선할지에 따른 제품별 임계값과 알림은 이 수집 설정과 따로 정해요.
이 문제는 beforeSendSpan을 추가하거나 SDK 옵션을 바꾼다고 풀리지 않아요. 앱은 span을 보내고 있지만 지금 서버 설정에서 저장하지 않는 상태라, 서버의 span ingestion 설정을 따로 확인해야 해요.
사내 Sentry를 에이전트가 조회하도록 MCP를 붙였어요
이슈를 조사할 때마다 대시보드를 열어 코드와 번갈아 보는 일이 번거로웠어요. Sentry MCP를 저장소에 연결해 에이전트가 이슈와 transaction, 프로젝트 설정을 읽으면서 코드를 따라갈 수 있게 했어요.
@sentry/mcp-server를 stdio로 실행하고 사내 Sentry 주소를 --host로 넘겼어요.
{
  "mcpServers": {
    "sentry": {
      "command": "npx",
      "args": ["-y", "@sentry/mcp-server@latest", "--host=sentry.example.com", "--disable-skills=seer"],
      "env": {
        "SENTRY_ACCESS_TOKEN": "${SENTRY_ACCESS_TOKEN}"
      }
    }
  }
}
사내 환경에서 쓸 수 없는 Seer 관련 도구는 껐어요. 토큰 값은 저장소에 넣지 않고 환경 변수 이름만 참조했어요.
MCP를 붙일 때는 터미널의 curl은 되는데 도구 호출만 인증에 실패했어요. Claude Code는 ${SENTRY_ACCESS_TOKEN}을 자기 프로세스 환경에서 치환하는데, 값은 Bash 도구에만 적용되는 로컬 설정에 있었어요. .env.local도 읽지 않았고요. 셸 시작 환경에 토큰을 두고 Claude Code를 다시 시작한 뒤에야 MCP에 전달됐어요.
MCP용 토큰과 소스맵 업로드용 토큰도 나눴어요.
- MCP 토큰: 이슈, 이벤트, 프로젝트를 조회하는 user auth token
- 빌드 토큰: 릴리스와 소스맵 artifact를 올리는 org token
MCP 토큰에는 project:releases 권한이 없어 빌드 업로드에 다시 쓸 수 없었어요. 같은 Sentry 토큰처럼 보여도 목적과 권한이 달랐어요.
INP를 조사할 때도 MCP로 transaction dataset과 이슈 payload를 읽었어요. 브라우저 코드가 지표를 빠뜨린 게 아니라 서버의 span 저장 단계가 꺼져 있다는 걸 이 값들과 대조해 찾았어요.
릴리스와 소스맵은 빌드 결과로 확인했어요
minify된 스택을 원본 코드로 연결하려면 소스맵 artifact가 실제 Sentry 프로젝트에 올라가야 해요. withSentryConfig에 사내 Sentry 주소와 조직, 프로젝트, 빌드 토큰을 연결했어요.
withSentryConfig(nextConfig, {
  sentryUrl: '<https://sentry.example.com/>',
  org: 'example',
  project: 'web',
  authToken: process.env.SENTRY_AUTH_TOKEN,
  telemetry: false,
  widenClientFileUpload: true,
  sourcemaps: {
    disable: !process.env.SENTRY_AUTH_TOKEN,
    deleteSourcemapsAfterUpload: true,
  },
  errorHandler: (error) => {
    console.warn('[sentry] 소스맵 업로드 실패:', error.message);
  },
});
소스맵 설정을 넣은 뒤에도 8일 동안 스택은 계속 minify된 채였어요. 배포 워크플로 어디에도 빌드 토큰이 없어서 sourcemaps.disable이 항상 참이었던 거예요. 업로드 설정에 문제가 생긴 게 아니라 배포에서 아예 실행되지 않고 있었어요.
Turbopack 빌드라서 처음에는 업로드가 동작하지 않는다고 생각했어요. 하지만 @sentry/nextjs 10.70은 Turbopack에서 production compile 이후 실행되는 훅으로 소스맵을 올려요. debug ID는 Next.js 16이 직접 만들고, Sentry는 그 ID를 기준으로 artifact bundle과 배포 파일을 연결해요.
토큰을 넣은 뒤에도 빌드 성공만으로 끝낼 수는 없었어요. 만료됐거나 권한이 없는 토큰은 업로드를 시도하다 401을 내지만, errorHandler가 경고만 남기면 빌드는 성공해요. deleteSourcemapsAfterUpload가 실패한 업로드의 로컬 소스맵까지 지울 수도 있고요.
이 경우 Sentry에도 배포 산출물에도 소스맵이 남지 않아요. sentry-cli로 릴리스 권한을 보고, Sentry API에서 artifact bundle이 생성됐는지 확인했어요.
서버 소스맵은 올리지 않기로 했어요. Turbopack은 .next/server에 소스맵을 항상 남기는데, 당시 빌드 기준으로 이 파일이 1,000개를 넘어 사내 Sentry가 업로드에 502를 냈고, 용량도 .next 199MB의 절반을 차지했어요. Sentry의 업로드보다 먼저 도는 빌드 훅에서 서버 소스맵을 지워 브라우저 소스맵만 올라가게 했더니, 같은 빌드에서 .next가 93MB로 줄었고 업로드도 502 없이 끝났어요. 대신 서버 쪽 스택은 minify된 채로 남아요.
배포된 오류를 원본 코드로 연결하려면 그 오류의 debug ID와 업로드된 artifact가 맞아야 해요. 그래서 최종적으로 확인한 것도 빌드 종료 코드가 아니라 이 연결이었어요.
에러 레벨은 상태 코드가 아니라 사용자 영향으로 정했어요
모인 이슈를 볼 수 있게 되니 어느 오류부터 고칠지도 정해야 했어요. 화면이 아예 뜨지 않는 오류와 다시 누르면 되는 요청이 같은 레벨로 쌓이면 목록에서 구분하기 어려웠어요.
이 기준의 출발점은 이전 회사에서 Sentry를 운영했던 경험과 우아한형제들의 「선제적 장애 대응을 위한 Sentry 최적화 적용기」였어요. 이전 회사에서는 브라우저 확장 프로그램, Service Worker, 네트워크 환경에서 반복되는 오류와, 이미 비즈니스 흐름에서 처리한 API 오류를 ignoreErrors, denyUrls, beforeSend로 선별하고 개발, 테스트 실행의 이벤트가 전송되지 않게 관리했어요. 모든 오류를 모으는 것보다 사용자에게 영향을 주는 오류를 놓치지 않는 게 중요하다는 걸 이때 배웠어요.
우아한형제들의 글은 과도한 오류가 수집 한도를 소진해 정작 중요한 장애 로그가 누락된 경험에서 출발해, 서비스 영향도에 따른 레벨, 불필요한 오류 필터링, 알림과 담당 절차를 함께 설계해요. 구현을 그대로 가져오지는 않았어요. 두 경험의 문제의식을 이 앱의 Next.js 런타임, 개인정보, 배포 환경에 맞게 다시 해석했어요.
처음에는 4xx와 5xx만으로 심각도를 나누려 했어요. 그런데 같은 500이라도 사용자가 겪는 결과는 요청의 역할에 따라 달랐어요.
| 요청 | 5xx | 4xx |
|---|---|---|
| GET: 화면을 채우는 호출 | fatal | error |
| 그 외: 사용자가 다시 시도할 수 있는 호출 | error | warning |
이 앱에서는 화면을 채우는 조회가 막힌 경우와 화면이 남아 있어 다시 시도할 수 있는 경우를 나누려고 이 기본 분류를 정했어요. 메서드만으로 영향을 모두 알 수는 없어서 핵심 동작이 막히거나 대체 흐름이 있는지는 별도로 봐요.
- fatal: 화면이 뜨지 않거나 핵심 조회 결과를 쓸 수 없는 경우
- error: 화면은 남아 있지만 사용자가 하려던 작업이 막힌 경우
- warning: 예상 가능한 실패이며 다시 시도하거나 대체 흐름으로 넘어갈 수 있는 경우
401도 전부 같은 방식으로 다루지 않았어요. 액세스 토큰 갱신으로 복구된 401은 보내지 않고, 토큰 갱신 요청 자체가 실패한 경우는 별도 fingerprint로 남겼는데요. 갱신 토큰이 수명대로 만료된 401은 돌아오는 사용자마다 나는 정상적인 세션 종료라 warning, 그 밖의 갱신 실패는 error로 나눴어요.
회원 id 하나만 붙였어요
영향받은 사용자 수를 알아야 한 명의 특이 사례와 여러 명이 겪는 장애를 나눠 우선순위를 정할 수 있어요. 그래서 브라우저 이슈에 회원 id 하나만 붙였어요. 이름, 이메일, 전화번호는 넣지 않았고, IP는 dataCollection의 userInfo: false로 SDK 쪽에서 막았어요.
서버 렌더에는 사용자를 붙이지 않았어요. 요청 스코프와 캐시된 렌더의 수명이 어긋나면 다른 요청의 이슈에 이전 사용자의 id가 남을 수 있거든요.
컴포넌트가 SDK의 setUser를 직접 부르지도 않아요. 공용 setSentryUser가 전송 게이트와 싣는 사용자 필드를 함께 관리해요.
고칠 수 없는 잡음은 발생 지점에서 표본만 남겼어요
개인정보 경로를 막고 나니 위치 조회 실패가 이슈 목록 위쪽을 채웠어요. 권한 거부는 사용자의 선택이라 보내지 않고, 위치 소스 없음과 시간 초과는 기기, 주변 환경의 영향이 커서 10%만 남겼는데요. 완전히 끄면 급증해도 알아챌 방법이 없어서 표본은 남겼어요.
오류 코드가 없는 실패는 전부 남겼어요. 앱 브리지 reject나 navigator.geolocation 부재처럼 우리 코드가 깨졌다는 신호일 수 있거든요.
처음에는 위치 조회 실패를 ignoreErrors로 거르려 했어요. 하지만 무시 목록은 메시지가 맞으면 버리는 것밖에 못 해서, 코드 2, 3은 표본만 남기고 코드가 없는 실패는 전부 남기는 규칙을 표현할 수 없었어요. 그래서 원본의 code를 볼 수 있는 위치 조회 코드에서 표본 여부를 정하고, fingerprint에는 오류 코드를 넣었어요.
이슈 제목도 문제였어요. GeolocationPositionError는 Error도 Event도 아니어서 SDK가 스택 없는 synthetic 예외로 보내고, 목록에는 제목이 <unknown>으로 떴어요. 읽히는 이름의 Error로 감싸고 원본은 cause로 붙였어요. fingerprint는 그대로 둬서 기존 이슈 그룹은 갈리지 않았어요.
전송 게이트로 의미 없는 트래픽을 줄였어요
이전 회사에서는 NODE_ENV를 기준으로 개발, 테스트 이벤트를 뺐어요. 단순하고 효과적이었지만, 로컬에서 실제 전송을 검증하거나 프로덕션 빌드로 E2E를 돌리는 것처럼 환경 이름과 수집 목적이 어긋나는 경우를 세밀하게 표현하긴 어려웠어요.
로컬에서 콘솔로 보고 있는 오류가 사내 Sentry에도 쌓이면 실제 사용자 문제와 섞여요. 이번에는 NODE_ENV 대신 실행 목적에 따라 전송 여부를 고르는 값을 두었어요.
DSN이 있더라도 NEXT_PUBLIC_SENTRY_ENABLED가 false면 SDK 전체가 꺼져요.
export const IS_SENTRY_ENABLED = Boolean(SENTRY_DSN) && SENTRY_ENABLED !== 'false';실사용자 오류를 받는 배포와 Sentry 전송을 확인하는 실행에서는 켜고, 일반 로컬 실행과 development 배포에서는 꺼요. dev, dev:mock, build:e2e의 기본값도 false로 두었어요. 전송 E2E나 로컬 연동 확인에서만 명시적으로 true를 줄 수 있어요.
처음에는 로컬에서 끄는 값을 .env.local에 넣었어요. 그러면 새 클론과 worktree에는 그 파일이 없어 .env.development의 true를 읽는 문제가 있었어요. 기본값을 실행 스크립트로 옮겨 새 작업 폴더도 수집하지 않는 상태로 시작하게 했어요.
이 체계가 먼저 알려 준 문제도 있었어요
Bottom Sheet를 드래그하다 놓으면 화면이 죽는 오류는 조사 당시 17명에게서 23건이 잡혔고(운영 배포 전까지 누적 57명 이상, 75건), 라이브러리 소스까지 따라가 원인 경로가 없는 버전으로 올렸어요.
응답 타입을 Zod 스키마에서 파생하며 null 허용 범위를 좁혔을 때는, 머지 전에 프로덕션 Sentry에 이미 쌓여 있던 스키마 불일치 33건과 대조해 서버가 실제로 null을 주는 자리를 찾아 되돌렸어요. dev 응답 12건에서는 전부 채워져 있던 필드가 프로덕션에서는 200건 중 27건이 null이었거든요. 그대로 배포했다면 화면은 멀쩡한 채 정상 응답마다 스키마 불일치 경고가 새로 쌓여 진짜 문제를 가렸을 거예요.
Sentry 워터폴을 보다가 메인 배너 링크가 뷰포트에 들어오는 것만으로 여러 라우트를 prefetch하는 것도 발견했어요. 해당 링크의 prefetch를 끄고 불필요한 요청이 더 나가지 않는 것을 확인했어요.
참고
- 우아한형제들 기술블로그 , 선제적 장애 대응을 위한 Sentry 최적화 적용기: 영향도별 레벨과 잡음 필터링의 출발점
- Next.js , instrumentation.js: register()와 onRequestError
- Next.js , instrumentation-client.js: 브라우저 초기화와 onRouterTransitionStart
- getsentry/sentry-javascript: @sentry/core의 requestDataIntegration과 sendDefaultPii 기본값 변환, fetch, xhr span 속성
- getsentry/sentry-mcp: @sentry/mcp-server의 -host 옵션
- 관련 글: Sentry로 추적한 Bottom Sheet 드래그 크래시
- 관련 글: 오류가 난 영역만 다시 시도하도록 Error Boundary 나누기